За последние годы стало очевидно: чем крупнее предобученная языковая модель, тем лучше она справляется с задачами обработки текста. Но у этого правила есть цена — обучение действительно больших и глубоких сетей превращается в инженерную головоломку. Главных проблем две: катастрофический аппетит к памяти GPU и время обучения, растягивающееся на недели.
Память одной видеокарты конечна, а современные модели давно переросли возможности единственного чипа. Поэтому индустрия выработала целый набор стратегий параллельного обучения — по данным, по слоям модели, по отдельным операциям — плюс архитектурные хитрости и техники экономии памяти, без которых обучение гигантских сетей было бы попросту невозможно.
- Почему обучение больших моделей — это в первую очередь про память
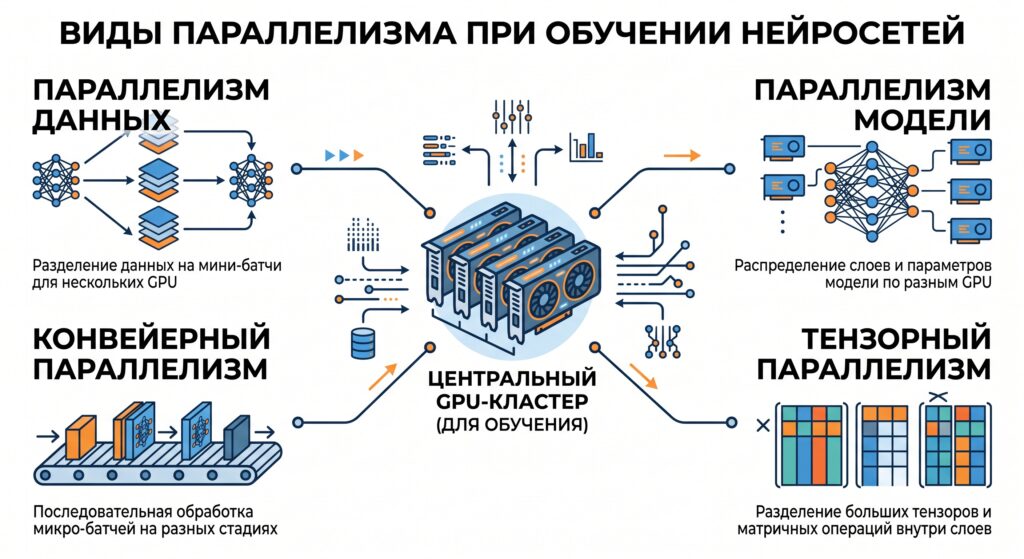
- Параллелизм по данным
- Параллелизм модели: когда сеть не помещается на одной карте
- Конвейерный параллелизм: борьба с простоями
- Тензорный параллелизм: разрезаем операции, а не слои
- Смесь экспертов (Mixture-of-Experts): масштаб без пропорционального роста вычислений
- Другие способы сэкономить память
- Итог
Почему обучение больших моделей — это в первую очередь про память
Помимо самих весов модели (десятки миллиардов чисел), в памяти нужно держать градиенты и состояния оптимизатора — а это, как правило, обходится ещё дороже, чем сами веса. Добавьте к этому огромные обучающие корпуса — и один-единственный процесс обучения может растянуться на месяцы.
Отсюда и необходимость параллелизма — распределения нагрузки сразу по нескольким измерениям: по данным, по частям архитектуры модели и по тензорным операциям внутри слоёв.
Параллелизм по данным
Самый интуитивный подход: скопировать модель целиком на каждый воркер, а обучающие данные — разбить между ними. Каждый воркер обрабатывает свой кусок данных параллельно с остальными.
Проблема очевидна: если модель сама по себе не помещается в память одной карты, наивное копирование не сработает. Решения вроде GeePS временно выгружают неиспользуемые параметры на CPU, когда GPU не хватает места, стараясь делать это в фоне, не мешая основным вычислениям.
В конце каждого шага обучения воркерам нужно синхронизировать результаты — и здесь есть два лагеря:
- Синхронный режим (BSP) — все воркеры ждут друг друга и синхронизируют градиенты в конце каждого мини-батча. Веса всегда актуальны, но есть простои в ожидании самого медленного воркера.
- Асинхронный режим (ASP) — каждый воркер работает в своём темпе, без ожидания. Простоев нет, зато веса могут оказаться устаревшими, что бьёт по качеству сходимости — иногда экономия времени на вычисления не даёт выигрыша в скорости обучения до нужной точности.
Компромиссный приём — накопление градиентов: синхронизация происходит не после каждого шага, а раз в несколько итераций. Это снижает частоту дорогих операций обмена данными между картами и увеличивает пропускную способность коммуникаций.
Параллелизм модели: когда сеть не помещается на одной карте
Если параллелизм данных распределяет батчи, то параллелизм модели (MP) распределяет саму сеть: параметры и вычисления делятся между машинами так, что ни одна из них не хранит модель целиком.
Раз глубокие сети — это, по сути, стопка последовательных слоёв, напрашивается простое решение: разрезать стопку по горизонтали и раздать куски разным воркерам. Но в лоб это не работает: из-за последовательной зависимости слоёв каждый воркер вынужден ждать, пока предыдущий закончит обработку — возникают огромные простои и вычислительные мощности используются впустую.
Конвейерный параллелизм: борьба с простоями
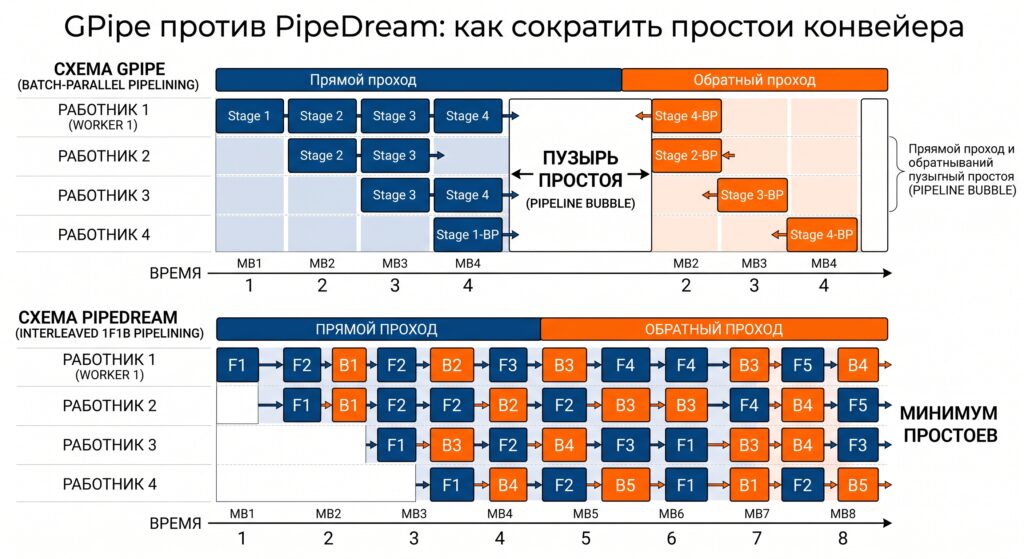
Конвейерный параллелизм (PP) соединяет идею разбиения модели по слоям с идеей параллелизма данных, чтобы «залатать» пустоты в конвейере. Мини-батч дробится на множество микро-батчей, и пока один воркер обрабатывает прямой проход для микро-батча №1, следующий воркер уже занят предыдущим микро-батчем — конвейер не простаивает.
GPipe объединяет градиенты со всех микро-батчей и применяет их синхронно в конце. Простои («пузыри») всё ещё есть, но исследователи показали: если число микро-батчей превышает число разбиений модели примерно в четыре раза, накладные расходы становятся практически незаметными.
PipeDream пошёл дальше и придумал схему чередования прямых и обратных проходов (1F1B — «один вперёд, один назад»), где каждый воркер попеременно выполняет то один тип прохода, то другой, без глобальной синхронизации в конце каждого батча. Плата за это — риск того, что прямой и обратный проход одного и того же микро-батча используют разные версии весов. Решается это либо хранением нескольких версий весов на каждом воркере, либо передачей номера версии весов вместе с активациями между воркерами.
Позже появились облегчённые модификации:
- PipeDream-flush периодически вставляет полную синхронизацию конвейера (как у GPipe), заметно экономя память ценой небольшой потери скорости.
- PipeDream-2BW хранит не одну, а ровно две версии весов («двойная буферизация»), чего достаточно, поскольку часть обратных проходов ещё зависит от предыдущей версии модели, пока новая только формируется.
Тензорный параллелизм: разрезаем операции, а не слои
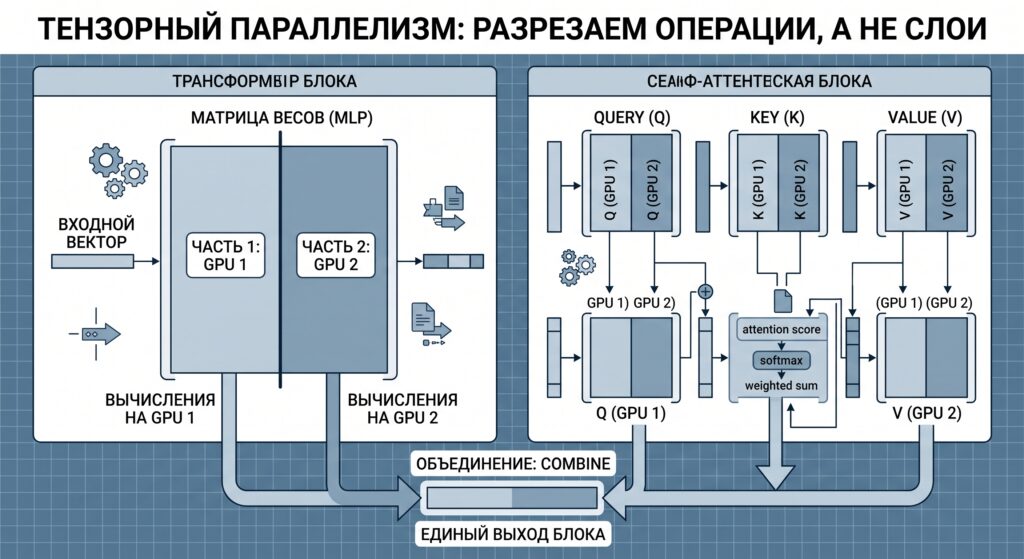
Если параллелизм модели и конвейерный параллелизм режут сеть «по вертикали» (по слоям), то тензорный параллелизм (TP) режет вычисления «по горизонтали» — прямо внутри одной операции, распределяя её между несколькими устройствами.
Возьмём трансформер — сегодня самую популярную архитектуру. Он состоит из полносвязных (MLP) блоков и блоков self-attention. Подход Megatron-LM предлагает изящное решение: разбить матрицу весов MLP-слоя по столбцам и раздать куски разным устройствам, а для attention-блока — распределить между устройствами вычисления, связанные с матрицами запросов, ключей и значений, объединяя результаты уже на финальном этапе.
Комбинация всех трёх видов параллелизма — конвейерного, тензорного и по данным — легла в основу подхода PTD-P. Его отличие в том, что модель нарезается не на непрерывные блоки слоёв, а на разрозненные, «перемешанные» фрагменты — например, один воркер получает слои 1, 2, 9 и 10, а другой — 3, 4, 11 и 12. Такая схема позволяет заметно сократить задержки конвейера по сравнению с классическим GPipe.
Смесь экспертов (Mixture-of-Experts): масштаб без пропорционального роста вычислений
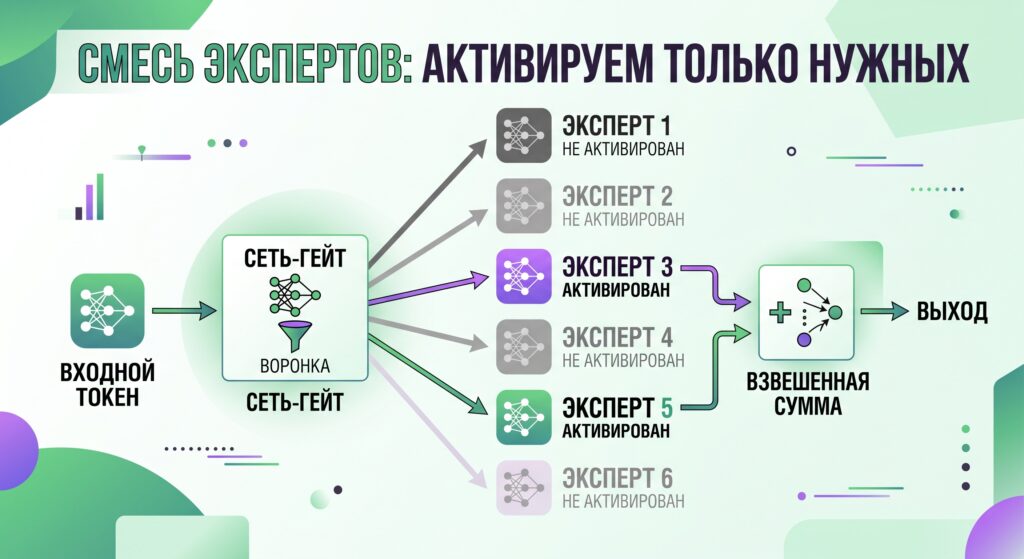
Идея MoE опирается на классический принцип ансамблевого обучения: несколько «слабых» моделей вместе работают лучше одной большой. Внутри одной сети это реализуется через управляющий механизм (gating network), который решает, какие из множества «экспертных» подсетей активировать для конкретного входа.
Слой MoE обычно включает набор экспертов (простых прямых сетей) и обучаемый гейт, который распределяет вероятности между ними и направляет данные только к нескольким выбранным экспертам — остальные просто не считаются, экономя вычисления.
Базовая версия гейта — softmax поверх произведения входа на обучаемую матрицу весов. Но такой подход активирует всех экспертов сразу, что не даёт экономии. Поэтому используется шумовой top-k гейтинг: оставляются только k наибольших значений, а остальные обнуляются; к тому же добавляется случайный шум для более равномерной балансировки нагрузки между экспертами. Отдельная вспомогательная функция потерь не даёт гейту «залипать» на нескольких любимых экспертах, вынуждая распределять нагрузку равномернее.
Поскольку каждый эксперт видит лишь часть выборки в батче, для MoE особенно важны крупные размеры батча — иначе отдельные эксперты просто не наберут достаточно данных для качественного обучения.
Дальнейшее развитие идеи:
- GShard масштабировал MoE-трансформер до 600 миллиардов параметров, заменяя часть полносвязных слоёв на MoE-слои и распределяя только их между машинами (остальные слои просто дублируются). Добавлены понятия «пропускной способности эксперта» (лимит токенов на эксперта), распределение токенов по группам и элемент случайности в маршрутизации.
- Switch Transformer довёл идею до предела, направляя каждый токен только к одному эксперту, что позволило довести размер модели до триллиона параметров. Для стабильности обучения авторы применяли выборочную точность FP32 внутри роутера, более консервативную инициализацию весов и повышенный dropout именно внутри экспертных слоёв.
- Expert Choice (EC) переворачивает логику: не токен выбирает эксперта, а эксперт выбирает, какие токены обработать. Это гарантирует идеальную балансировку нагрузки без риска «переполнения» и, по данным экспериментов, вдвое ускоряет сходимость обучения. Минус — метод плохо работает с маленькими батчами и не годится для авторегрессивной генерации текста, поскольку требует знания будущих токенов заранее.
Другие способы сэкономить память
Помимо распределения нагрузки между устройствами, существует набор приёмов, снижающих требования к памяти на каждом отдельном GPU.
Выгрузка на CPU. Когда память видеокарты заполнена, часть данных временно перекладывается на CPU и подгружается обратно по мере необходимости. Метод рабочий, но со временем стал менее популярным — он заметно замедляет обучение.
Пересчёт активаций (activation recomputation / checkpointing). Хитрый трюк: вместо того чтобы хранить все промежуточные активации, сохраняются только «опорные точки» на границах разбиения сети, а всё, что между ними, пересчитывается заново во время обратного прохода. Это позволяет добиться сублинейного роста затрат памяти относительно глубины сети — ценой дополнительного одного прямого прохода.
Обучение со смешанной точностью. Использование чисел половинной точности (FP16) вместо FP32 резко сокращает объём памяти и ускоряет вычисления, но требует аккуратности:
- держать «эталонную» копию весов в FP32, к которой применяются градиентные обновления, а для прямого и обратного прохода использовать округлённую FP16-версию;
- масштабировать значение функции потерь, чтобы небольшие градиенты не обнулялись из-за ограниченного диапазона FP16;
- некоторые арифметические операции (например, суммирование по вектору) выполнять с накоплением в FP32, сохраняя лишь финальный результат в FP16.
Сжатие промежуточных данных. Между первым и вторым использованием карт признаков (в прямом и обратном проходах) есть временной разрыв, который можно использовать: система Gist, например, сжимает промежуточные результаты после первого использования — где-то без потерь (например, бинаризация ReLU-паттернов), а где-то с контролируемой потерей точности. Это давало до двукратного сокращения затрат памяти почти без потери качества модели.
Оптимизаторы, экономные к памяти. Популярный Adam хранит импульсы и дисперсии в том же масштабе, что и сами параметры — то есть требует в разы больше памяти, чем веса модели. Альтернативы вроде Adafactor обходятся хранением скользящих сумм по строкам и столбцам вместо полных матриц, а SM3 предлагает похожий адаптивный подход с существенной экономией.
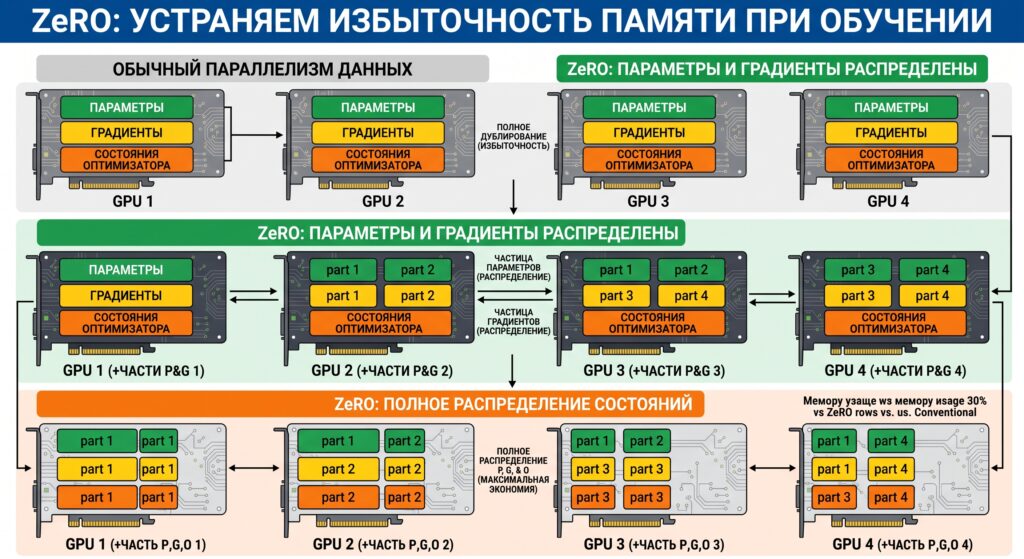
Отдельного упоминания заслуживает подход ZeRO (Zero Redundancy Optimizer): он делит все затраты памяти на две категории — состояния модели (веса, градиенты, состояния оптимизатора) и «остаточные» затраты (активации, буферы, фрагментация памяти). ZeRO-DP устраняет избыточное дублирование состояний модели между воркерами при параллелизме данных, распределяя их между устройствами, а ZeRO-R оптимизирует память за счёт разделённого пересчёта активаций и дефрагментации на лету.
Итог
Ни один из перечисленных методов не решает проблему обучения гигантских моделей в одиночку. На практике современные системы комбинируют параллелизм данных, конвейеров и тензоров с приёмами вроде пересчёта активаций, смешанной точности и экономных оптимизаторов — и именно эта комбинация делает возможным обучение моделей с триллионами параметров на тысячах GPU.