Современные языковые модели способны писать статьи, программировать, анализировать документы и поддерживать сложный диалог. Однако сама по себе большая нейросеть не гарантирует качественного результата.
Модель, обученная на миллиардах текстов, умеет предсказывать следующее слово, но не всегда понимает, какой именно ответ нужен человеку. Она может написать технически правильный текст, но выбрать неподходящий стиль, допустить логические ошибки или дать слишком общий ответ.
Поэтому развитие искусственного интеллекта сегодня связано не только с созданием более крупных моделей, но и с разработкой методов управления их поведением.
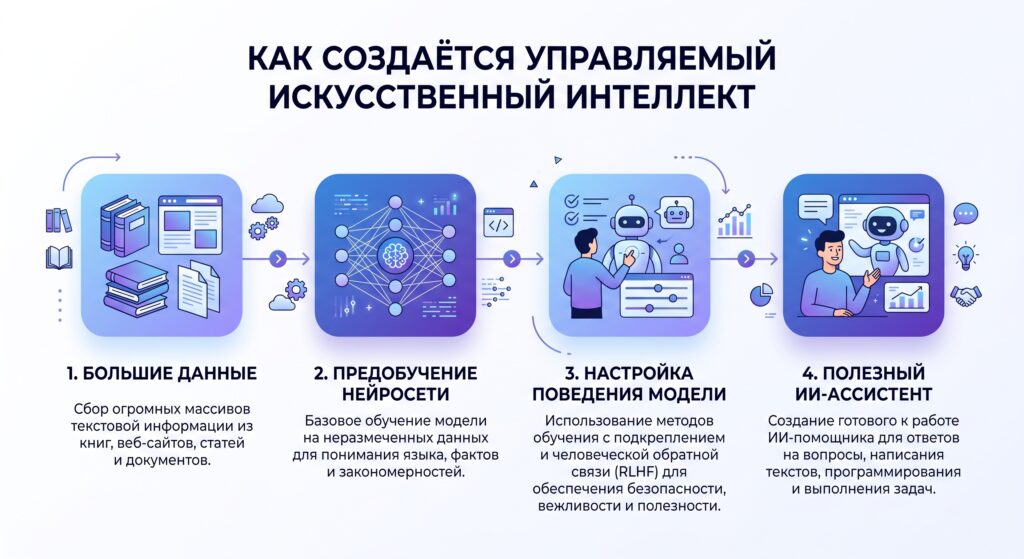
- Почему нейросети необходимо контролировать
- Управление генерацией: как нейросеть выбирает слова
- Prompt Engineering: управление через правильные инструкции
- Дообучение моделей: создание специализированного поведения
- RLHF: обучение искусственного интеллекта на человеческих предпочтениях
- Управляющие модели: контроль без полного переобучения
- Будущее больших языковых моделей
- Заключение
Почему нейросети необходимо контролировать
Большие языковые модели обучаются на огромных массивах данных: книгах, статьях, сайтах и других текстовых источниках. Во время обучения они изучают закономерности языка и учатся прогнозировать наиболее вероятное продолжение текста.
Однако вероятность слова не равна его полезности для человека. Например, модель может выбрать наиболее частый ответ, но он не обязательно будет самым точным или удобным.
Главная задача разработчиков — научить модель не просто генерировать текст, а учитывать цели пользователя:
- соблюдать заданный стиль;
- отвечать понятно для конкретной аудитории;
- избегать нежелательного содержания;
- следовать инструкциям;
- создавать более точные и полезные ответы.
Управление генерацией: как нейросеть выбирает слова
Первый способ управления моделью — изменение процесса генерации текста. При создании ответа нейросеть каждый раз выбирает следующий токен (часть слова или слово), основываясь на вероятностях.
Самый простой подход — жадное декодирование. В этом случае модель всегда выбирает самый вероятный вариант. Такой метод работает быстро, но часто приводит к повторениям и шаблонным ответам.
Более современные методы используют вероятностный выбор:
- Top-k — модель выбирает слово среди нескольких наиболее вероятных вариантов.
- Top-p — модель динамически определяет набор подходящих вариантов на основе их общей вероятности.
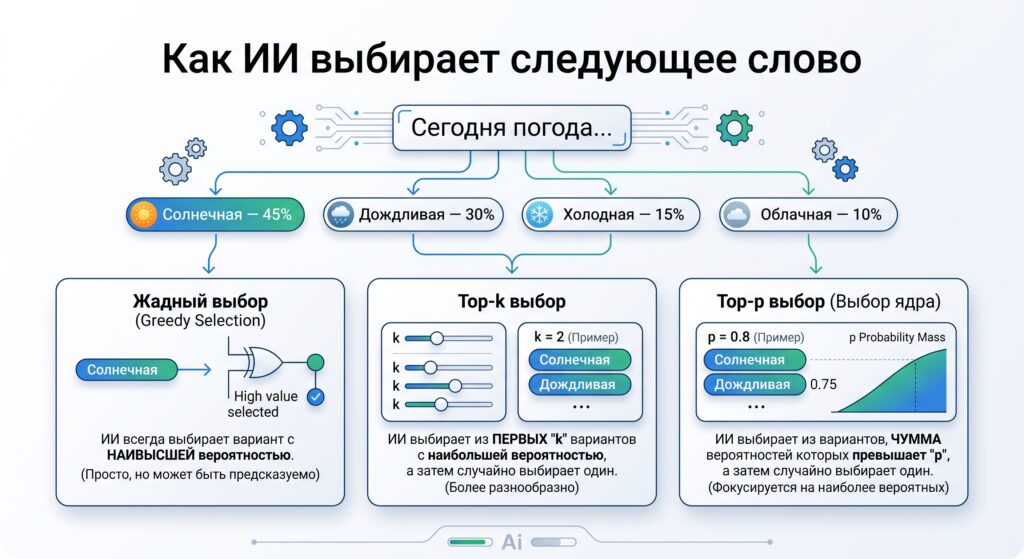
Эти методы позволяют сделать ответы более естественными и разнообразными, сохраняя контроль над качеством текста.
Prompt Engineering: управление через правильные инструкции
Один из самых доступных способов изменить поведение нейросети — правильно составить запрос. Это направление получило название prompt engineering.
Большая языковая модель не получает задачу так, как её понимает человек. Она анализирует текстовый контекст, поэтому качество результата напрямую зависит от того, насколько точно сформулирована инструкция.
Например, простой запрос:
«Напиши статью про медицину»
может дать общий материал.
Но запрос:
«Ты врач-эксперт. Подготовь образовательную статью для студентов медицинского университета. Используй структуру: причины, симптомы, диагностика и лечение»
значительно лучше задаёт направление работы модели.
Современные исследования показывают, что даже небольшие изменения в формулировке запроса могут существенно изменить качество ответа.
Дообучение моделей: создание специализированного поведения
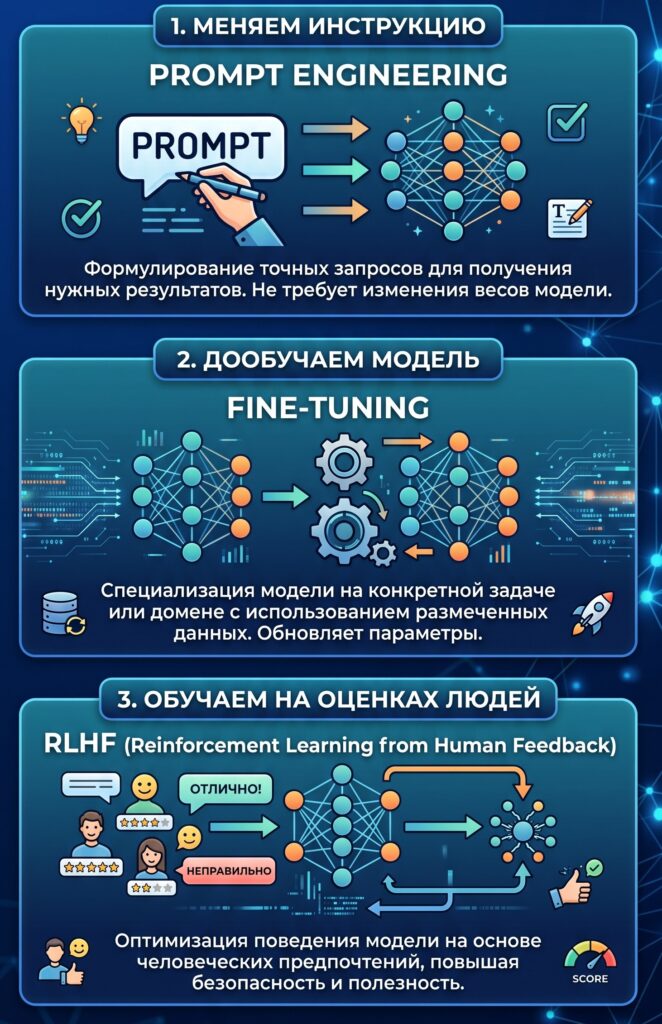
Если промптов недостаточно, применяется fine-tuning — дополнительное обучение уже существующей модели на специальных данных.
Например, универсальная языковая модель может быть адаптирована для:
- медицинских консультаций;
- юридических документов;
- службы поддержки клиентов;
- анализа технической документации.
При этом модель не создаётся заново. Она уже обладает знаниями языка, а дополнительное обучение меняет её поведение под конкретную задачу.
Главный недостаток метода — необходимость качественных данных и значительных вычислительных ресурсов.
RLHF: обучение искусственного интеллекта на человеческих предпочтениях
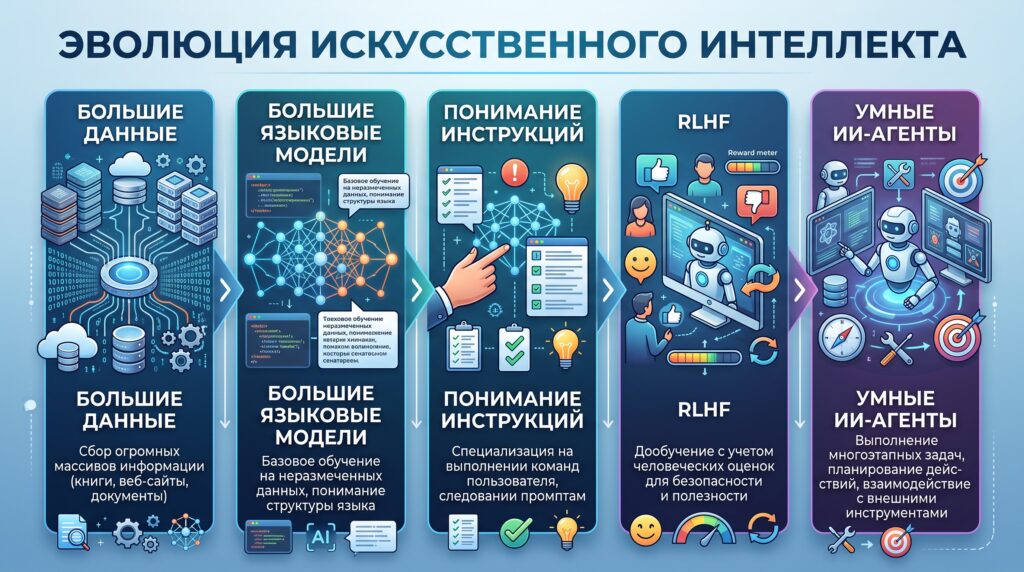
Одним из наиболее важных методов развития современных ИИ-ассистентов стало обучение с подкреплением на основе человеческой обратной связи — RLHF (Reinforcement Learning from Human Feedback).
Идея метода заключается в том, что модель учится не только на текстах, но и на оценках людей.
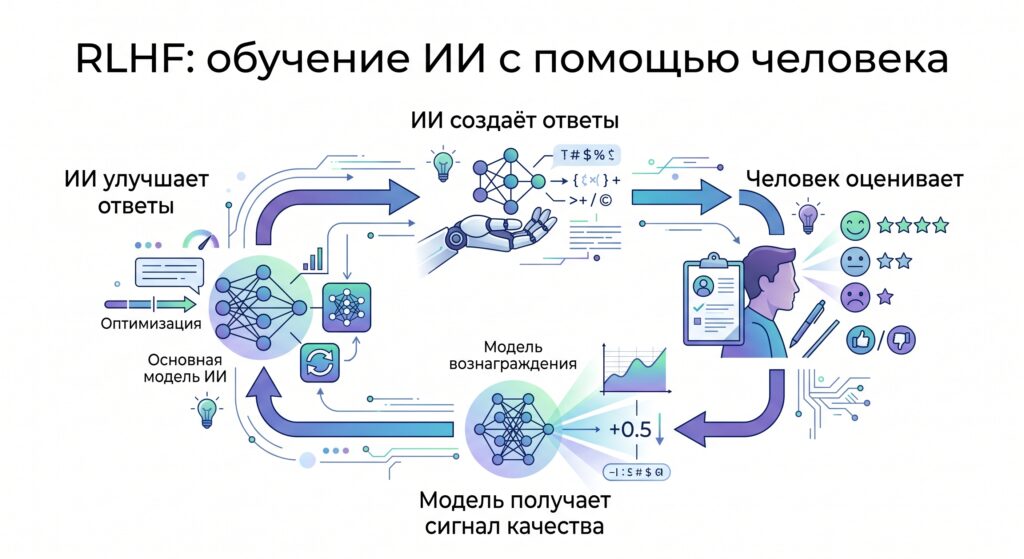
Процесс выглядит следующим образом:
- Нейросеть создаёт несколько вариантов ответа.
- Человек оценивает, какой вариант лучше.
- На основе этих оценок создаётся модель качества.
- Основная модель обучается чаще выбирать предпочтительные ответы.
Благодаря RLHF искусственный интеллект становится более ориентированным на человека: лучше выполняет инструкции, поддерживает диалог и формирует более полезные ответы.
Управляющие модели: контроль без полного переобучения
Полное переобучение большой языковой модели является дорогим процессом. Поэтому исследователи разработали методы, позволяющие управлять поведением модели без изменения всех её параметров.
Для этого используются дополнительные управляющие слои или отдельные модели-контроллеры.
Например, одна система может отвечать за стиль текста, другая — за безопасность, третья — за соответствие определённой теме.
В результате одна большая модель может использоваться для разных задач без необходимости создавать отдельную нейросеть под каждую область.
Будущее больших языковых моделей
Развитие искусственного интеллекта постепенно меняет главный вопрос отрасли.
Раньше разработчики стремились создать модели с максимально большим количеством параметров. Сегодня всё больше внимания уделяется тому, насколько хорошо модель понимает человека и умеет управляемо применять свои знания.
Будущие системы будут сочетать несколько технологий:
- мощные базовые языковые модели;
- точные инструкции через промпты;
- специализированное обучение;
- обратную связь от людей;
- системы контроля поведения.
Таким образом, главный этап развития ИИ — это переход от просто больших моделей к действительно полезным и управляемым интеллектуальным системам.
Заключение
Большие языковые модели уже обладают огромными возможностями, но их качество определяется не только объёмом данных и количеством параметров. Настоящий прорыв происходит тогда, когда разработчики умеют правильно направлять поведение искусственного интеллекта.
Промпты, дообучение, RLHF и управляющие механизмы становятся инструментами, которые превращают универсальную нейросеть в специализированного цифрового помощника.